项目说明
每个展项的做法与难点,想看完整方案可电话或微信沟通。
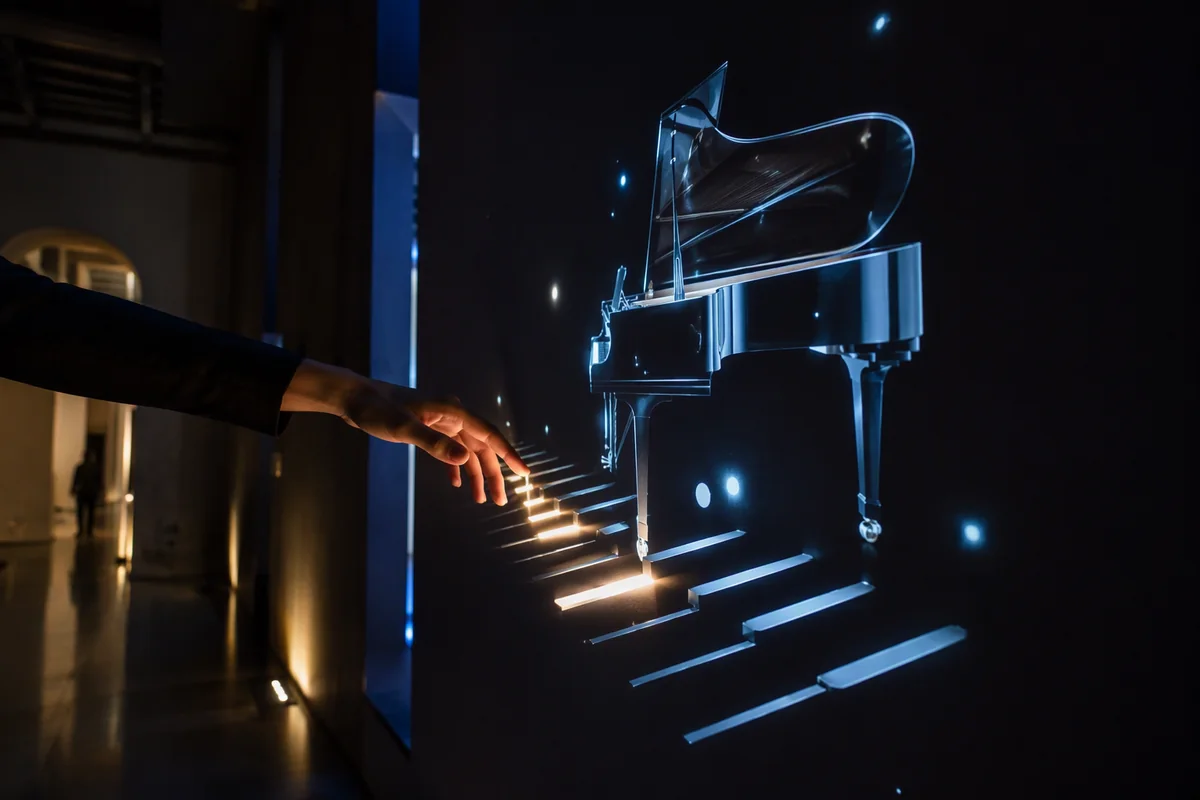
红外/体感识别手的位置,隔空按下即发声。支持多人同时弹,音阶可按曲子定制。难点在识别区域的标定——手在空中的位置要准到能分辨相邻琴键,否则弹出来是乱的。
把情绪识别做成本地离线部署:一台主机加普通摄像头,识别在本地跑,人脸数据不出设备。满足馆方对数据安全的要求,断网也能用。
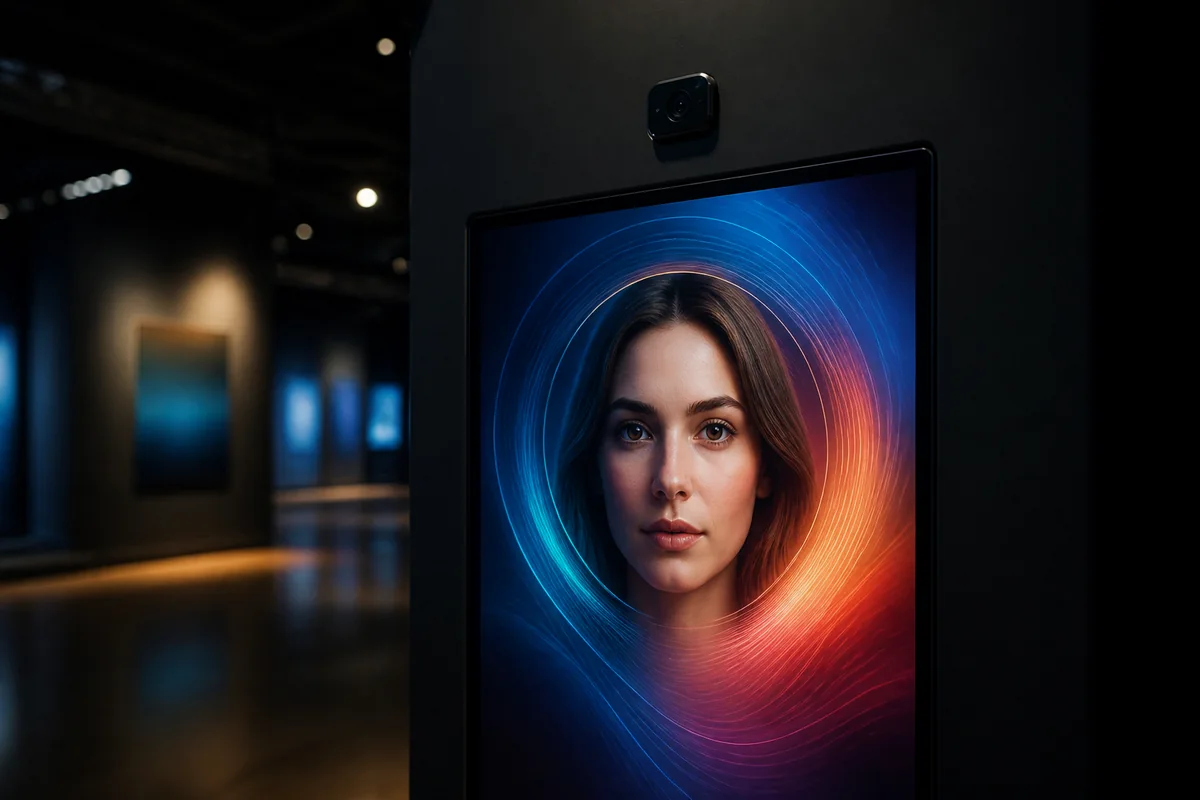
用普通摄像头做表情识别,不依赖深度相机。好处是成本低、部署简单;代价是光线要求高,需要现场补光和对位。
输入一段文字,分析情绪倾向并可视化。适合心理科普和 AI 体验展项;本地运行,不依赖云端接口。
麦克风实时分析音量/音调,驱动画面变化。适合声学展项和互动装置;难点是环境噪声抑制,否则旁边人说话也会触发。
文本/语音情感分析,输出情绪类别和强度曲线。适合企业展厅的 AI 能力展示;可对接自己的内容库,不限于通用模型。
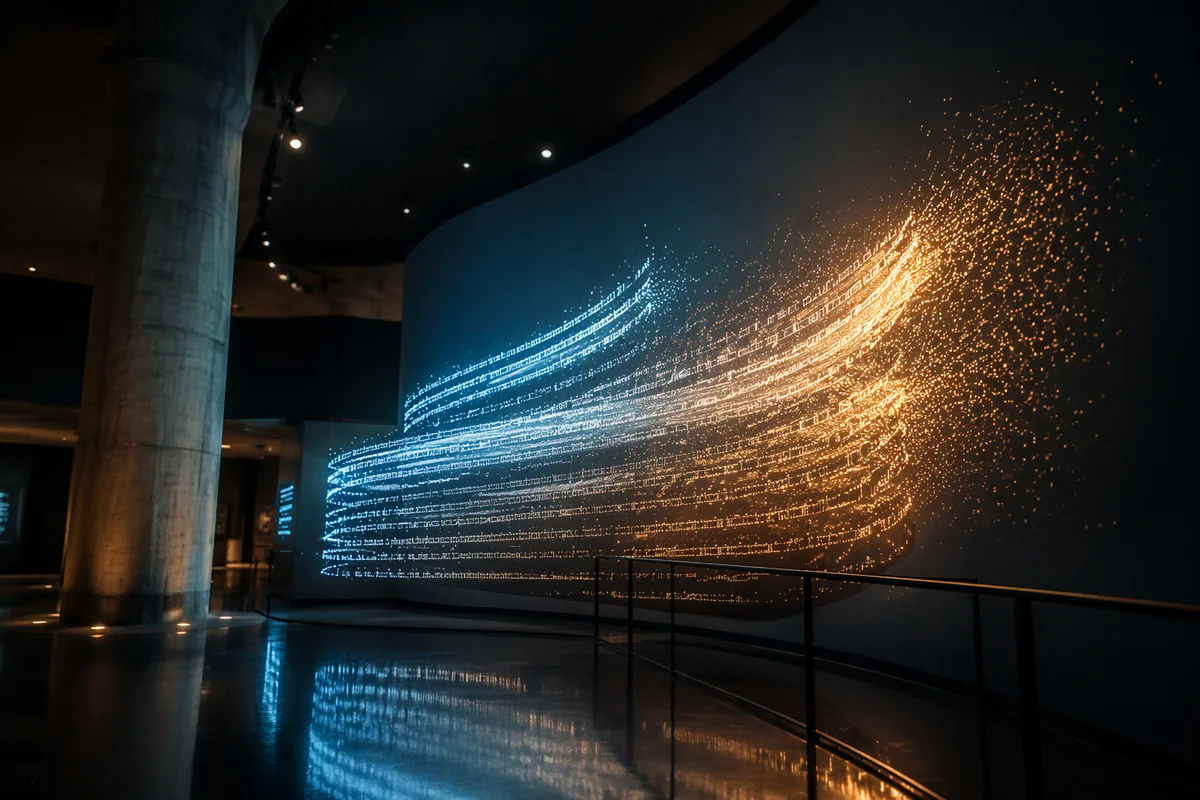
摄像头跟踪手部位置,画面中的光点/光带跟随手移动、聚集或散开。适合展厅氛围墙和品牌馆互动区,视觉反馈越直接,观众越愿意伸手。
不只识别表情类别,还检测面部肌肉的细微动作(眉、眼、嘴角),用于心理测评和微表情研究。精度依赖现场光照和摄像头位置。
区分"社交微笑"和"真实微笑":看眼轮匝肌是否参与。做成展项时不做绝对判断,只给参考提示,避免观众觉得被冒犯。
同一套微表情识别,换个包装做"笑脸测试"。观众对着屏幕笑,系统提示真实度。适合科技馆的轻互动展项,排队率很高。
虚实叠加:识别真实展品或观众位置,把虚拟信息精确叠加上去。关键是透视和比例校准,否则会"飘"。
拉线位移传感器采集拉动幅度,映射到二胡音高和音量。适合非遗展馆;手感要调——拉太轻没声、太重像坏的。
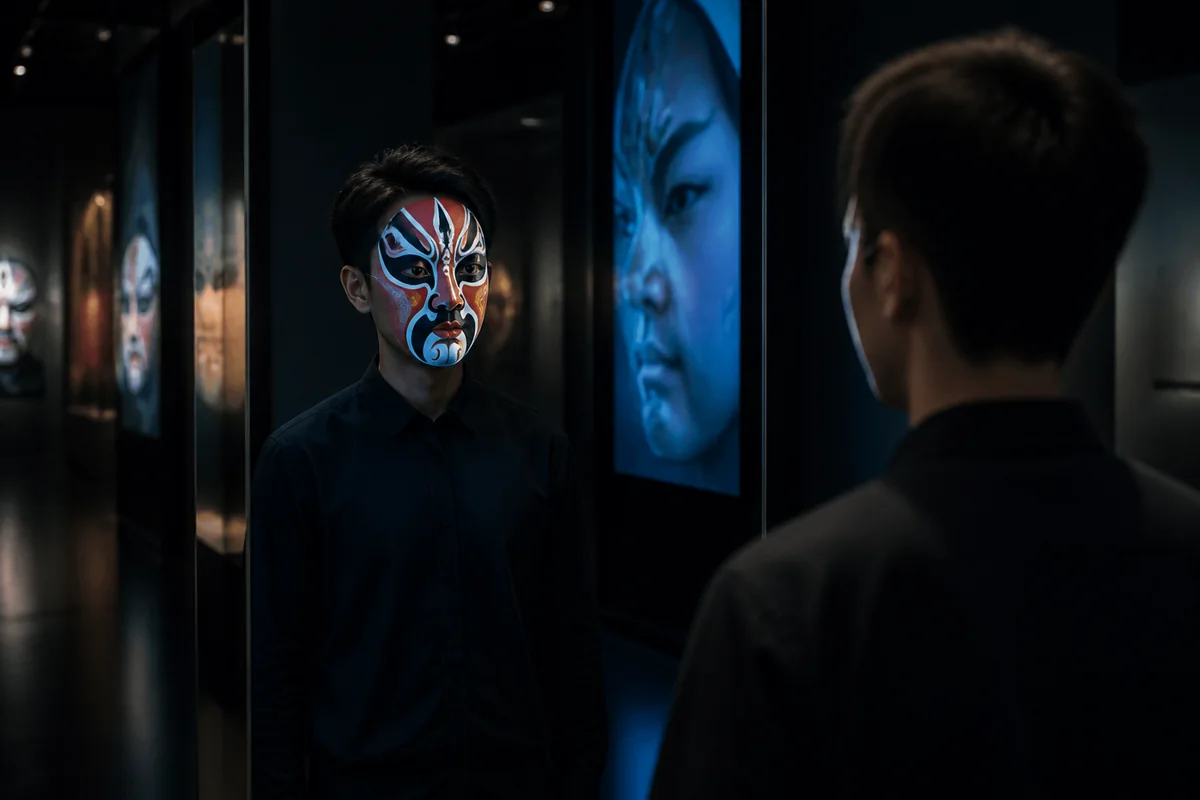
人脸关键点对齐后,把脸谱/面具按五官位置贴合,转头时跟着动。适合戏曲、非遗、民俗主题展项。
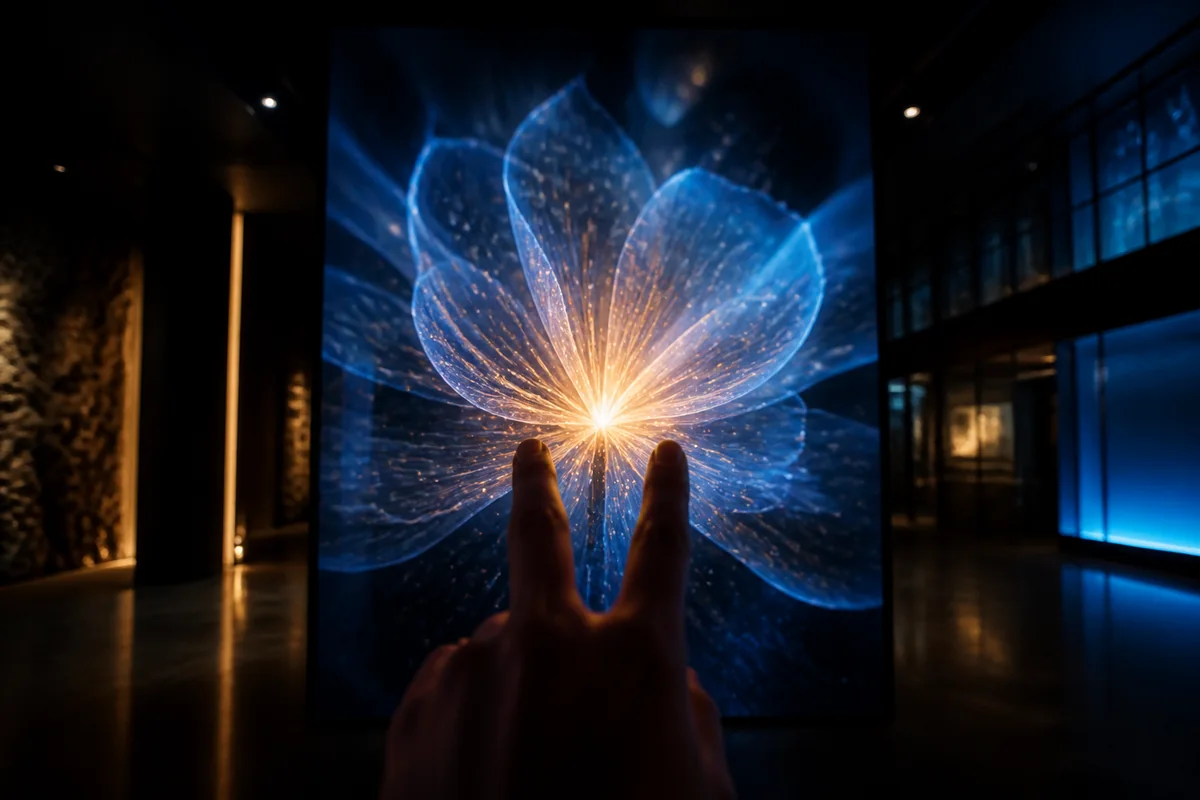
识别手指张合动作,驱动画面中的花朵绽放/收拢。动作→反馈延迟要压到 100ms 内,否则观众会觉得"不跟手"。
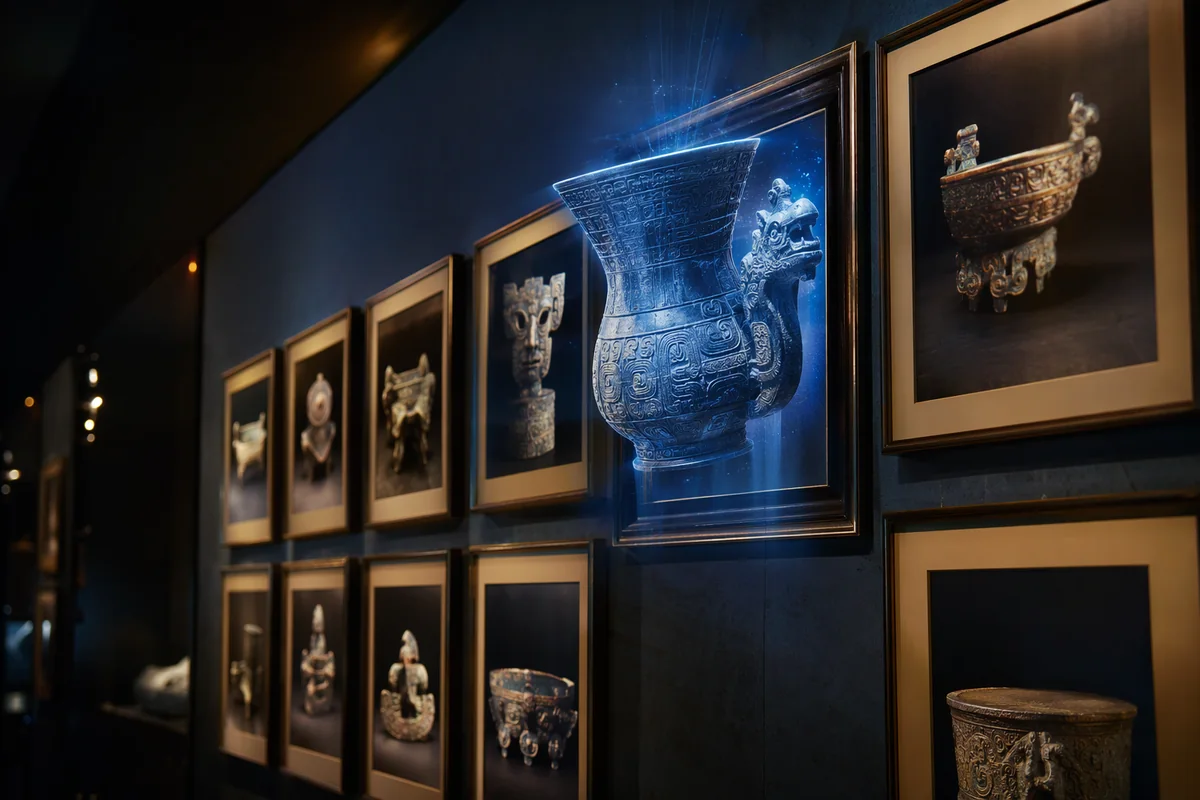
照片墙里的文物可点选,点中后该文物从墙面"浮出"到前景,展开细节和讲解。适合文博展陈,把静态照片墙变成可探索的界面。
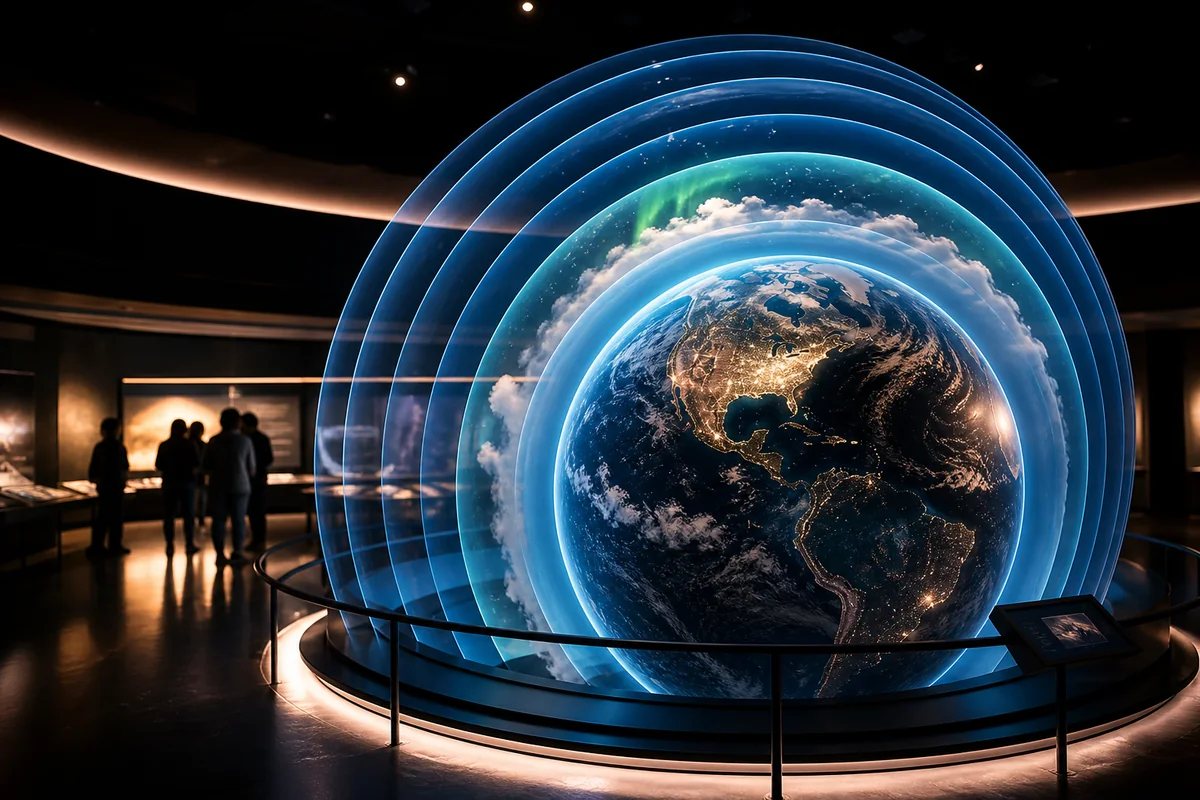
分层展示大气结构,点选每层看图、看数据、看现象。适合科技馆气象展项;内容可后台维护。
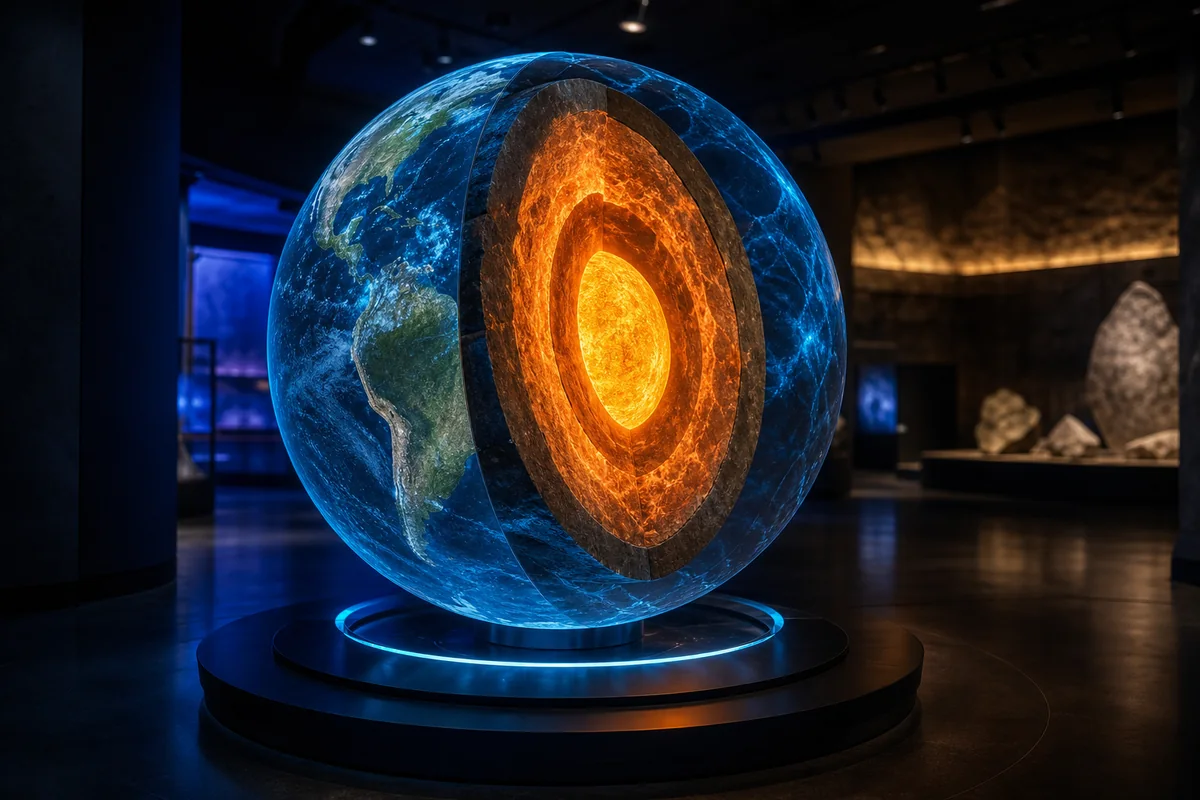
地壳/地幔/地核分层剖切,可旋转、缩放、点选查看。适合地球科学展项。
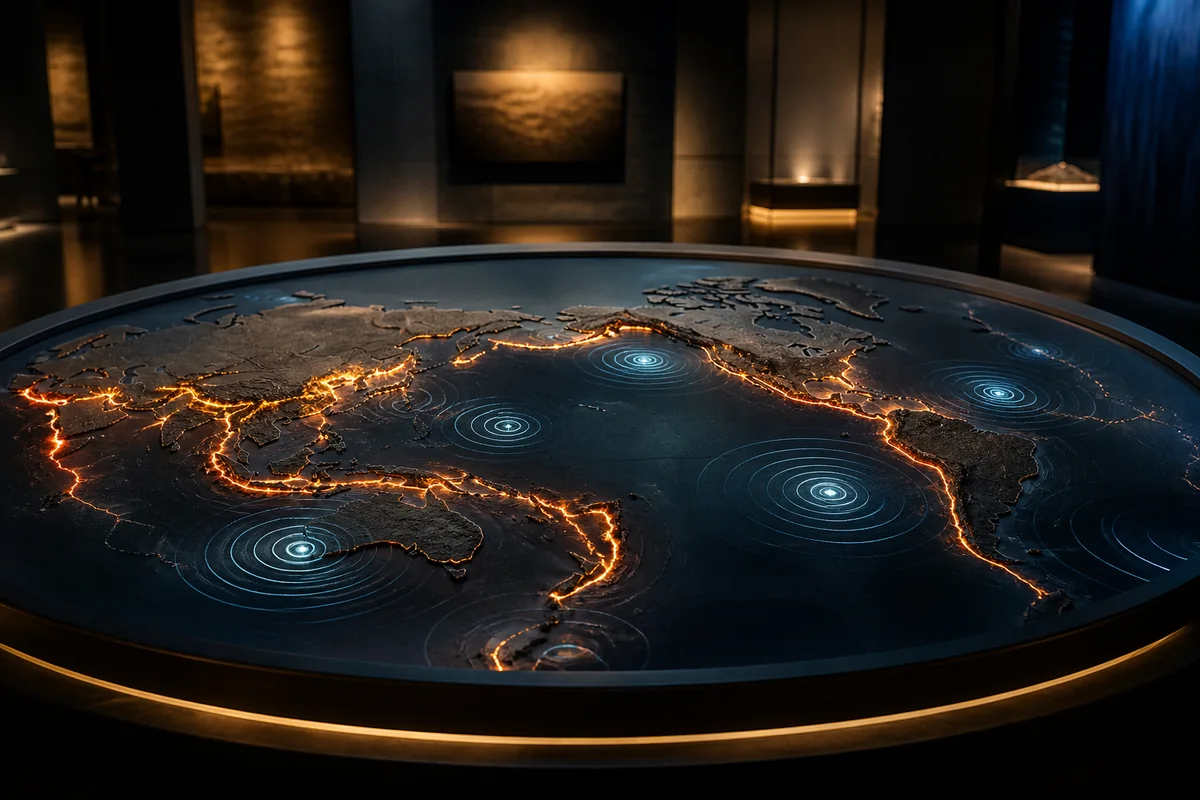
世界地图上标注地震带、历史震中,可筛选、可回放。适合防震减灾科普馆。
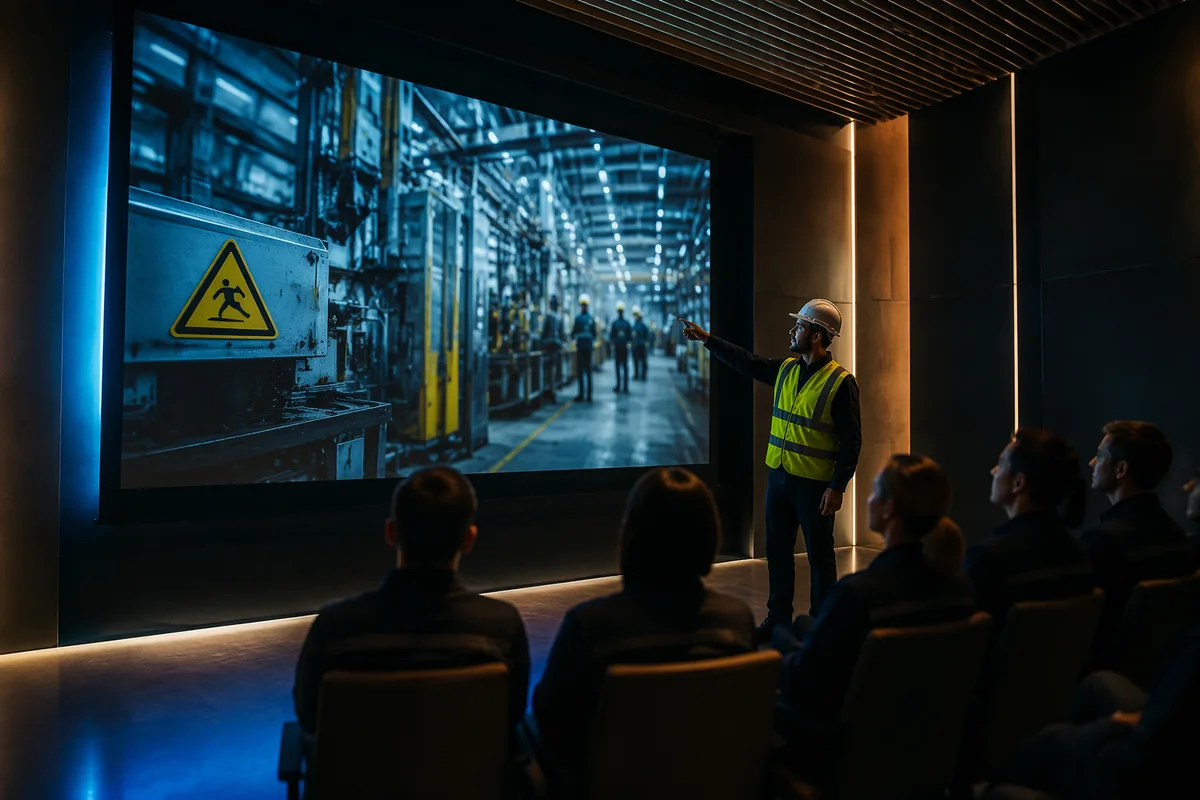
场景化找隐患:点选画面中的危险源,系统判定并讲解。适合安全培训、校园安全教育。
楼层/科室/专家查询,触摸屏自助使用。适合医院大厅;内容后台可维护。
时间轴展示气象观测史,配合仪器实物或图片。适合气象科普馆。
鱼类图鉴式查询:点选鱼种看形态、习性、分布。适合自然教育、水族馆。